20 тыс.
Открытая выборка
CC BY 4.0. Подписи, семантические категории, оценки качества, палитры и готовые сплиты.
Hugging FaceИсследовательский кейс / Опубликовано
Я построил пайплайн данных, обучения и инференса для трансформера, который генерирует изображения в нативном разрешении 24×24 по тексту и пятицветной палитре.
Что может выучить небольшая модель, если заранее ограничить разрешение и палитру? PixelGPT генерирует изображение в пространстве индексов палитры. Каждое из 576 предсказаний определяет цвет одного пикселя.
Исходная исследовательская коллекция объединяет нативные изображения 24×24, подписи и пятицветные палитры. Скрипт обучения загружает индексы пикселей и палитры, сопоставляет эмбеддинги подписей MiniLM с изображениями и выделяет валидационную выборку с фиксированным seed.
Пайплайн релиза проверяет размеры и палитры, исключает отмеченные примеры, присваивает публичные категории и экспортирует воспроизводимые сплиты. В открытой выборке сбалансированы категории, а близкие дубликаты остаются в одном сплите, чтобы снизить утечку данных. Около 218 тыс. примеров относятся к запуску обучения. Размеры двух опубликованных выборок приведены ниже.
20 тыс.
CC BY 4.0. Подписи, семантические категории, оценки качества, палитры и готовые сплиты.
Hugging Face216 838
Отобранные изображения с метаданными, сплитами и офлайн-просмотрщиком с семантическим поиском и экспортом.
itch.io14-слойный decoder-only трансформер с шириной 512 и восемью головами внимания предсказывает один из пяти индексов палитры в каждой позиции. Эмбеддинг MiniLM размерности 384 и выбранная RGB-палитра кондиционируют каждый блок через адаптивную нормализацию.
Последовательность строится змейкой по блокам 4×4. При инференсе используются classifier-free guidance, температура и top-p сэмплирование. Индексы затем раскладываются обратно в двумерную сетку.
В README проекта описан запуск примерно на 218 тыс. примеров, который занял около 30 минут на одной NVIDIA RTX 5090. Время относится к этому запуску.
PyTorch-тренер использует teacher forcing и кросс-энтропию предсказания следующего индекса палитры. Цикл валидации вычисляет функцию потерь на отложенных токенах и сохраняет сетки примеров для фиксированных подписей и палитр.
Тренер считает ошибку предсказания токенов на отложенной выборке. Я также просматривал сетки генераций с разными запросами и палитрами. Ниже приведены примеры такой качественной проверки. Формального бенчмарка качества изображений или соответствия запросу нет.
Локальное приложение принимает seed, запрос, палитру и настройки сэмплирования, чтобы можно было воспроизвести и сравнить результаты в одной среде.
Сетки из локальных запусков. В подписях оставлены исходные запросы на английском.
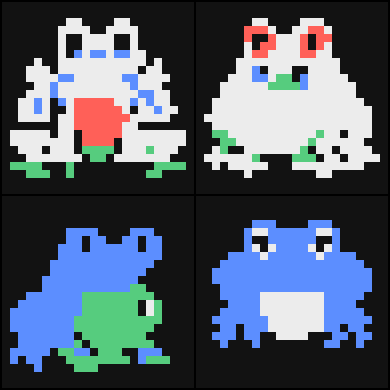
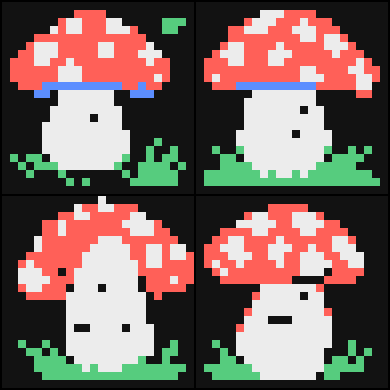
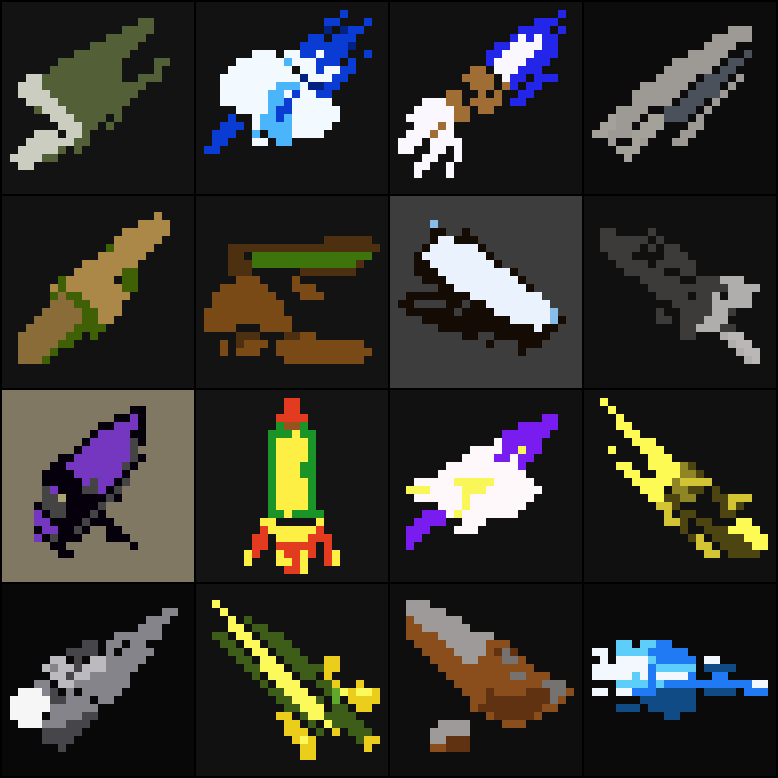
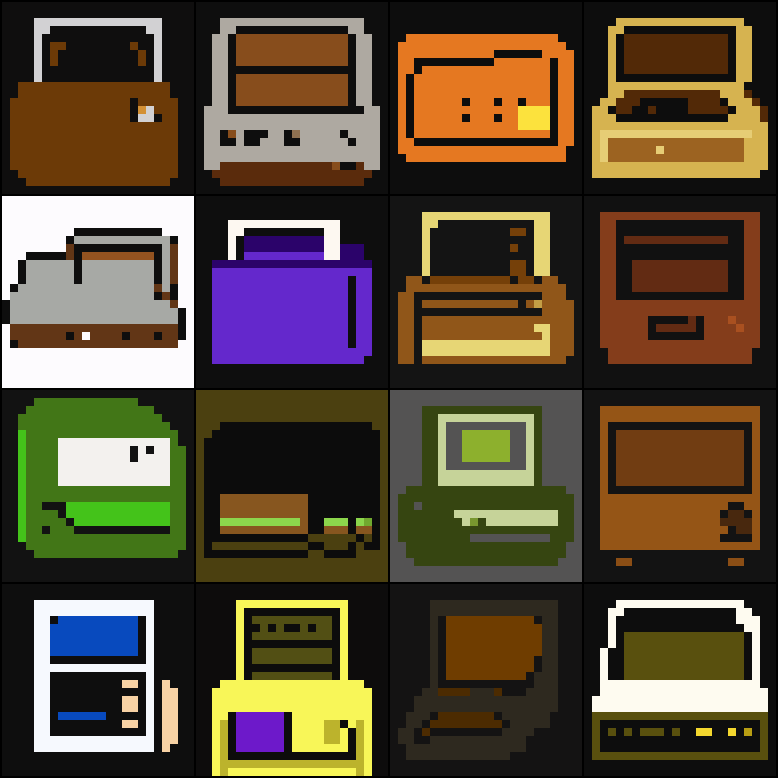
Релиз на GitHub запускает FP16-генератор и MiniLM в локальном процессе Python/FastAPI. Редактор в браузере обращается к локальному API. /api/generate возвращает итоговое изображение, а /api/generate/stream передаёт промежуточные сетки в NDJSON каждые 24 шага.
Опубликованное демо использует отдельный клиентский порт. Web Worker запускает ONNX Runtime Web с WASM, INT8-декодером и KV-кэшем. Пиксели поступают в редактор по мере генерации без запроса к серверу инференса. Загрузка моделей и генерация на CPU могут занять время.
В открытом доступе есть исходный код, локальное приложение и открытая выборка. Полный датасет продаётся отдельно, у него есть покупатели. По состоянию на 7 ноября 2026 года открытую выборку скачали более 500 раз за предшествующий месяц.
Разрешение и палитра ограничивают детализацию, а текстовый энкодер лучше работает с короткими запросами о конкретных объектах. Даже с KV-кэшем 576 последовательных предсказаний увеличивают задержку.
Индексы палитры сразу задают ограничения вывода и позволяют менять цвета в редакторе без повторного инференса. В другой узкой задаче я сначала проверил бы, какие ограничения можно заложить в представление данных и какие свойства нужно проверять на отложенных примерах.
Откройте демо в браузере, изучите реализацию на Python или посмотрите один из двух релизов датасета.